Файл .htaccess часто воспринимают как простой и бесплатный способ защитить сайт от ботов. В интернете можно найти сотни готовых фрагментов кода для блокировки User-Agent, отдельных IP-адресов, диапазонов адресов, подозрительных запросов и автоматизированных клиентов. На первый взгляд решение кажется логичным: добавить несколько правил — и нежелательный трафик перестанет попадать на сайт.
На практике возможности .htaccess значительно уже. Этот файл действительно полезен для решения ряда серверных задач, однако превращать его в полноценную систему управления веб-трафиком рискованно. Чем сложнее становится набор правил, тем выше вероятность ложных блокировок, ошибок конфигурации, проблем с производительностью и нарушения работы самого сайта.
Разберём, как работает .htaccess, какие задачи он способен решать, почему простая блокировка ботов через .htaccess не является полноценной защитой и чем профессиональная фильтрация трафика отличается от набора локальных правил на сервере сайта.
Что такое .htaccess
.htaccess — это конфигурационный файл, позволяющий изменять определённые параметры работы веб-сервера для конкретного сайта или отдельного каталога без редактирования основной серверной конфигурации.
Название происходит от исторического назначения файла — управления доступом к каталогам. Со временем возможности .htaccess значительно расширились, и сегодня через него могут задаваться различные правила обработки HTTP-запросов.
Файл обычно располагается в корневом каталоге сайта, однако дополнительные .htaccess-файлы могут находиться и во вложенных директориях. Настройки из них применяются с учётом структуры каталогов и конфигурации сервера.
Важно: .htaccess — не отдельная система безопасности и не сетевой экран. Это локальный механизм конфигурации веб-сервера, который начинает работать уже на сервере, где размещён защищаемый сайт.
По какому принципу работает .htaccess
Когда на сайт приходит HTTP- или HTTPS-запрос, веб-сервер определяет, существуют ли для соответствующего каталога локальные правила .htaccess, и применяет разрешённые администратором директивы.
В зависимости от серверной конфигурации через .htaccess можно:
- выполнять перенаправления;
- изменять URL;
- ограничивать доступ к отдельным каталогам и файлам;
- разрешать или запрещать обращения с определённых IP-адресов;
- анализировать некоторые HTTP-заголовки;
- задавать правила обработки ошибок;
- управлять определёнными параметрами кеширования;
- устанавливать часть параметров выполнения веб-приложения;
- ограничивать выполнение отдельных сценариев;
- реализовывать простые условия допуска или отклонения запросов.
Именно возможность проверять IP-адрес, URL или значение User-Agent привела к распространению идеи использовать .htaccess для защиты сайта от ботов.
Однако здесь принципиально важно понимать место такой проверки в архитектуре сайта: запрос уже дошёл до инфраструктуры размещения сайта. Сервер уже принял соединение и должен обработать правила, прежде чем решить, разрешать запрос дальше или отклонить его.
На каких видах хостинга можно использовать .htaccess
Применение .htaccess возможно только тогда, когда используемый веб-сервер поддерживает этот механизм и хостинг-провайдер разрешил соответствующие директивы.
Чаще всего .htaccess встречается на классическом виртуальном хостинге, где владелец сайта не имеет доступа к глобальной конфигурации сервера. В такой ситуации локальный конфигурационный файл удобен: пользователь может самостоятельно изменить некоторые параметры сайта без обращения к администратору хостинга.
На VPS, VDS и выделенных серверах также возможно использование .htaccess, если соответствующая технология предусмотрена веб-сервером и включена в его настройках. Но при наличии полного административного доступа многие задачи рациональнее решать непосредственно на уровне основной конфигурации сервера.
Существуют и веб-серверы, которые не обрабатывают .htaccess как механизм локальной конфигурации. Поэтому копирование готового файла с одного хостинга на другой вовсе не гарантирует его работу.
Вывод: .htaccess нельзя считать универсальной технологией защиты сайта. Его наличие и набор доступных возможностей зависят от конкретной серверной среды и политики хостинг-провайдера.
Для чего .htaccess предназначен в первую очередь
Главная ценность .htaccess заключается не в борьбе с ботами, а в возможности локально управлять поведением сайта.
Типичные практические задачи:
- перенаправление старых URL на новые;
- настройка постоянных и временных редиректов;
- формирование человекопонятных адресов страниц;
- ограничение доступа к отдельным служебным каталогам;
- запрет прямого открытия определённых файлов;
- назначение собственных страниц ошибок;
- настройка некоторых HTTP-заголовков;
- управление кешированием статических ресурсов;
- ограничение доступа к административным или техническим областям сайта.
Для таких локальных задач .htaccess остаётся полезным инструментом.
Проблемы начинаются тогда, когда его пытаются превратить в систему интеллектуальной классификации входящего трафика: отличать посетителей от автоматизированных клиентов, отделять полезных роботов от вредоносных, анализировать последовательности действий и принимать решения на основании большого количества взаимосвязанных признаков.
Можно ли заблокировать ботов через .htaccess
Технически — да. Простые виды блокировки реализовать возможно.
Обычно применяют несколько подходов.
Блокировка по User-Agent
Браузеры и автоматизированные клиенты передают серверу заголовок User-Agent. Если в нём содержится известное название нежелательного робота, запрос можно отклонить.
Условная логика выглядит так:
Если User-Agent содержит название нежелательного бота:
    запретить запрос
Для примитивных краулеров такой механизм действительно может работать.
Но User-Agent передаётся самим клиентом. Боту ничего не мешает представиться обычным браузером, поисковым роботом или другим разрешённым клиентом.
Поэтому правило вида «если написано BadBot — блокировать» защищает в основном от тех ботов, которые добровольно признаются, что являются BadBot.
Блокировка по IP-адресу
Можно запретить обращения с конкретного IP-адреса либо определённого диапазона.
Такой способ эффективен, когда источник нежелательной активности известен и использует относительно стабильную инфраструктуру.
Однако современный автоматизированный трафик часто распределяется между тысячами или десятками тысяч адресов. Используются облачные сети, прокси, мобильные подключения, динамические адреса и различные распределённые инфраструктуры.
После блокировки одного адреса следующий запрос может прийти с другого.
Блокировка определённых URL
Через серверные правила можно ограничивать обращения к:
- страницам авторизации;
- служебным URL;
- определённым каталогам;
- техническим обработчикам;
- часто атакуемым endpoint’ам;
- отдельным функциям сайта.
Это полезно, если задача сводится к простому правилу: «к этому адресу извне обращаться нельзя».
Но в реальном проекте один и тот же URL зачастую должен одновременно оставаться доступным обычным посетителям, поисковым системам, административным функциям, интеграциям и другим легитимным клиентам. Простого запрета становится недостаточно.
Блокировка по HTTP-заголовкам
Некоторые администраторы пытаются анализировать Referer, Accept-Language, User-Agent и другие доступные признаки HTTP-запроса.
Это расширяет возможности фильтрации, но сохраняется та же фундаментальная проблема: многие заголовки формируются самим клиентом и легко имитируются автоматизированным программным обеспечением.
Почему блокировки через .htaccess быстро становятся неуправляемыми
Первые несколько правил обычно выглядят просто:
- запретить несколько User-Agent;
- заблокировать несколько IP;
- ограничить один служебный URL.
Затем появляются исключения.
Одно правило блокирует полезного робота — требуется исключение. Второе мешает внешнему сервису. Третье затрагивает административную функцию. Затем появляется новый вид ботов, который нужно определить уже по нескольким условиям.
Через некоторое время конфигурация превращается в цепочку зависимых правил:
если условие A — блокировать,
кроме случая B,
но только если отсутствует C,
при наличии D пропустить,
для URL E сделать исключение,
для определённого клиента применить другое правило.
Чем больше таких условий, тем сложнее проверить их взаимное влияние.
В итоге файл, который изначально состоял из десяти строк, может превратиться в большую конфигурацию, любое изменение которой требует осторожного тестирования.
Недостатки управления трафиком через .htaccess
Основная проблема заключается не в том, что .htaccess «плохой». Проблема в попытке использовать инструмент не для той задачи, для которой он оптимален.
1. Фильтрация происходит на сервере самого сайта
Нежелательный запрос уже дошёл до инфраструктуры размещения проекта.
Даже если он будет отклонён до выполнения CMS, сервер всё равно должен принять запрос, разобрать его и применить необходимые правила.
При небольшом количестве автоматизированных обращений это может быть незаметно. При значительном потоке становится важным сам факт того, где находится точка фильтрации.
2. Нет полноценного контекста поведения посетителя
Отдельный HTTP-запрос далеко не всегда выглядит вредоносным.
Например, запрос:
GET /catalog/product/
может сделать и обычный посетитель, и поисковый робот, и парсер.
Разница становится заметна в последовательности действий:
- скорости переходов;
- частоте запросов;
- порядке обхода страниц;
- стабильности параметров клиента;
- повторяемости поведения;
- обращениях к связанным функциям;
- общем профиле активности.
.htaccess в первую очередь работает с текущим запросом, а не с полноценной поведенческой картиной клиента.
3. User-Agent нельзя считать доказательством личности
Если запрос сообщает:
User-Agent: обычный браузер
это не означает, что перед сервером действительно находится человек.
Современные инструменты автоматизации способны воспроизводить заголовки и особенности обычных браузеров намного точнее, чем примитивные скрипты прошлых лет.
4. IP-адрес тоже недостаточен
Один IP может использоваться множеством легитимных пользователей, а один бот способен менять адрес после каждого нескольких запросов.
Поэтому стратегия постоянного добавления адресов в чёрный список постепенно превращается в бесконечную борьбу с последствиями.
5. Сложно безопасно пропускать поисковых роботов
Особенно опасна примитивная защита, которая делит запросы только по User-Agent.
Нельзя строить логику:
если написано "поисковый робот" → разрешить
Злоумышленник или парсер может отправить точно такое же значение.
С другой стороны, чрезмерно жёсткие ограничения могут начать блокировать настоящих поисковых роботов, ухудшая обход сайта и потенциально создавая проблемы для SEO.
6. Трудно анализировать причины блокировок
Когда правил становится много, владельцу сайта необходимо понимать:
- какое условие сработало;
- почему запрос был заблокирован;
- какой тип клиента выполнял запрос;
- не произошло ли ложного срабатывания;
- нужно ли изменить правило;
- как изменение повлияет на другие группы пользователей.
Простой локальный конфигурационный файл не является полноценной аналитической системой.
Негативные последствия чрезмерной защиты через .htaccess
Самая опасная ситуация возникает не тогда, когда правило не блокирует бота, а тогда, когда оно начинает блокировать легитимный трафик.
Блокировка реальных посетителей
Слишком широкие ограничения по IP, заголовкам или URL могут затронуть обычных пользователей.
Причём владелец сайта может долго этого не замечать: сайт открывается у него самого, поэтому кажется, что всё работает.
Проблемы с поисковой индексацией
Ошибка в правилах допуска поисковых роботов способна ограничить доступ поисковой системы к части сайта.
Особенно рискованны правила, в которых настоящие поисковые роботы определяются только по строке User-Agent или, наоборот, блокируются целые диапазоны адресов без понимания их назначения.
Нарушение работы форм и динамических функций
Современный сайт состоит не только из обычных HTML-страниц.
Пользователь взаимодействует с:
- формами;
- поиском;
- фильтрами;
- авторизацией;
- корзиной;
- оформлением заказа;
- AJAX-функциями;
- API;
- личным кабинетом;
- служебными обработчиками.
Жёсткое правило, созданное ради борьбы с ботами, может неожиданно нарушить одну из этих функций.
Ошибки конфигурации могут сделать сайт недоступным
.htaccess чувствителен к синтаксису и доступным серверным директивам.
Некорректное правило способно привести не просто к неправильной фильтрации, а к серверной ошибке при открытии сайта.
Рост сложности сопровождения
Чем больше правил добавляется, тем дороже становится каждое последующее изменение.
Нужно помнить, зачем появилось конкретное исключение, какие функции от него зависят и что произойдёт после его удаления.
В какой-то момент владелец сайта фактически получает самодельную систему безопасности без полноценного интерфейса управления, аналитики и контроля изменений.
Особенно опасна ситуация: правила копируются из разных инструкций в интернете без понимания порядка их выполнения и взаимодействия между собой. Каждый отдельный фрагмент может выглядеть логично, но их комбинация способна давать совершенно другой результат.
Влияет ли большой .htaccess на производительность сайта
Это зависит от архитектуры сервера, числа правил, частоты обращений и характера конфигурации.
Но общая закономерность понятна: чем больше логики необходимо проверять для каждого входящего запроса, тем больше вычислительной работы требуется серверу.
Особенно нерационально превращать .htaccess в огромную базу:
- IP-адресов;
- User-Agent;
- регулярных выражений;
- исключений;
- вложенных условий;
- индивидуальных правил для десятков URL.
Парадокс заключается в том, что инструмент, предназначенный для защиты сайта от нагрузки автоматизированного трафика, сам начинает добавлять работу серверу при обработке каждого запроса.
Почему защита по User-Agent создаёт ложное чувство безопасности
Один из самых распространённых «антибот»-списков для .htaccess выглядит концептуально так:
BadBot
Crawler123
ParserXYZ
ScannerBot
UnknownBot
...
После добавления сотни названий создаётся ощущение, что сайт получил серьёзную защиту.
Но эффективному автоматизированному клиенту достаточно сменить строку:
ParserXYZ
на строку обычного браузера — и вся эта база перестаёт иметь значение для конкретного запроса.
Поэтому User-Agent полезен как один из множества сигналов, но не должен рассматриваться как самостоятельное доказательство того, кто находится перед сервером.
Можно ли защитить сайт списками IP
Чёрные списки IP также полезны как один из инструментов фильтрации. Если определённая сеть стабильно генерирует нежелательный трафик, её ограничение может дать эффект.
Но защита сайта только через IP-листы сталкивается с несколькими проблемами:
- адреса изменяются;
- одна инфраструктура может использовать множество подсетей;
- боты способны использовать распределённые прокси;
- один адрес иногда обслуживает легитимных пользователей;
- списки требуют постоянного обновления;
- репутация адреса меняется со временем.
Поэтому профессиональная система не должна принимать все решения только на основании IP.
Почему блокировка страны тоже не решает проблему ботов
Географическая фильтрация полезна, когда бизнес действительно не работает с посетителями из определённых регионов.
Однако страна происхождения запроса сама по себе ничего не говорит о его качестве.
Бот может работать из той же страны и даже из той же сети, что и целевая аудитория сайта.
Поэтому географический признак — это ещё один дополнительный сигнал, а не универсальный способ определить автоматизацию.
Является ли защита через .htaccess настоящей защитой сайта
Ответ зависит от того, что именно понимать под защитой.
Если задача звучит:
«Запретить известному IP-адресу открывать конкретный каталог»
— .htaccess способен решить её вполне успешно.
Если задача звучит:
«Отделять реальных посетителей, поисковых роботов, парсеров, поведенческих ботов, сканеры, автоматизированные запросы и вредоносную активность, сохраняя нормальную работу сайта»
— одного .htaccess уже недостаточно.
Набор локальных правил может создать ощущение контроля, но наличие длинного списка запретов ещё не означает наличие полноценной системы защиты.
.htaccess — инструмент конфигурации. WAF — инструмент фильтрации и защиты веб-трафика. Эти технологии решают принципиально разные по масштабу задачи.
Чем профессиональная защита от ботов отличается от .htaccess
Профессиональная система защиты должна анализировать входящий веб-трафик до того, как запрос будет передан основному сайту.
Вместо одного условия вида:
User-Agent → разрешить / запретить
решение должно приниматься на основании совокупности признаков.
Это позволяет построить многоуровневую фильтрацию.
Первый уровень — очевидно нежелательный трафик
На раннем этапе могут отсекаться запросы, для которых уже имеется достаточно признаков нежелательной или вредоносной активности.
Нет необходимости передавать такой запрос приложению сайта и заставлять CMS выполнять лишнюю работу.
Второй уровень — техническая классификация клиента
Если одного признака недостаточно, учитывается совокупность характеристик запроса и клиента.
Цель заключается не в поиске одной «волшебной строки», а в сопоставлении нескольких независимых сигналов.
Третий уровень — работа с поведением
Значительная часть современных ботов старается выглядеть как обычный пользователь.
Отличия проявляются не в одном запросе, а в характере активности:
- частоте переходов;
- повторяемости запросов;
- последовательности действий;
- обходе большого количества страниц;
- аномальной работе с фильтрами и поиском;
- массовом обращении к динамическим функциям;
- неестественной интенсивности действий.
Четвёртый уровень — индивидуальные правила сайта
Два сайта редко требуют абсолютно одинаковой защиты.
Интернет-магазин, корпоративный сайт, сервис с API и проект с личным кабинетом имеют разные сценарии нормального поведения.
Поэтому эффективная защита должна учитывать:
- структуру конкретного проекта;
- его формы;
- поиск и фильтры;
- авторизацию;
- API;
- динамические функции;
- служебные endpoint’ы;
- характер реального пользовательского трафика.
Как правильно пропускать поисковых роботов
Поисковые роботы — отдельная важная категория автоматизированного трафика.
Их нельзя просто приравнивать ко всем остальным ботам, поскольку обход страниц необходим для присутствия сайта в поисковых системах.
Но нельзя и безусловно доверять запросу только потому, что его User-Agent содержит название поисковой системы.
В профессиональной схеме используются несколько уровней проверки.
Упрощённо логика выглядит так:
- запрос заявляет себя поисковым роботом;
- проверяются дополнительные технические признаки;
- сопоставляется источник запроса;
- анализируется соответствие ожидаемому профилю;
- только после проверки применяется доверенный режим.
Такой подход позволяет одновременно:
- не мешать нормальной индексации;
- не давать обычному парсеру пройти только благодаря поддельному User-Agent;
- разделять доверенные и недоверенные автоматизированные запросы.
Почему облачная WAF-защита эффективнее локальных правил
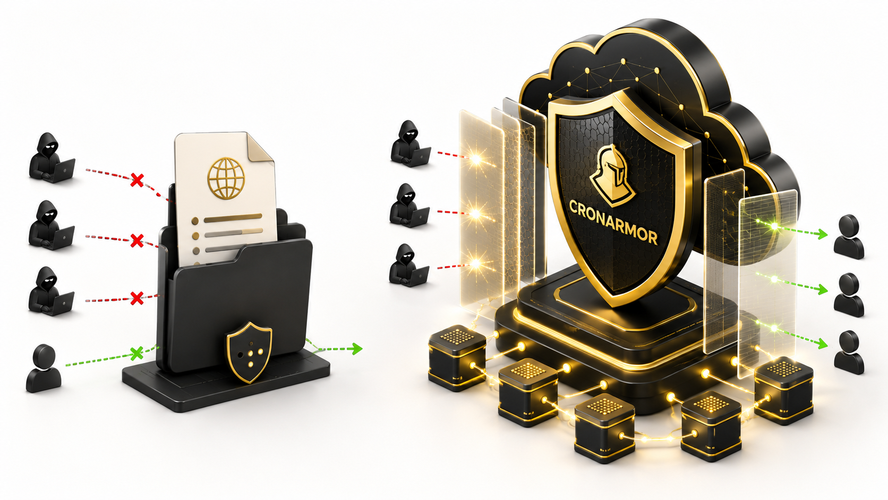
Главное архитектурное отличие заключается в расположении точки фильтрации.
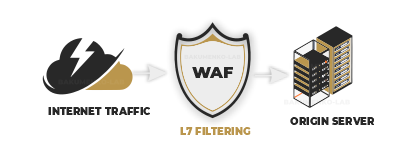
При использовании облачного WAF-шлюза входящий веб-трафик сначала проходит через защитный контур, и только после проверки разрешённые запросы передаются на сайт.
Схема выглядит так:
Посетитель или автоматизированный клиент
        ↓
облачный защитный контур
        ↓
многоуровневая проверка HTTP/HTTPS-трафика
        ↓
разрешённый запрос
        ↓
сайт
В отличие от локального .htaccess, защита не ограничивается одним файлом правил внутри инфраструктуры самого сайта.
Многоуровневая фильтрация CRONARMOR
CRONARMOR использует облачный WAF-контур для фильтрации автоматизированного и вредоносного веб-трафика до его передачи на защищаемый сайт.
Вместо попытки решить все задачи одним правилом применяется последовательная система проверок.
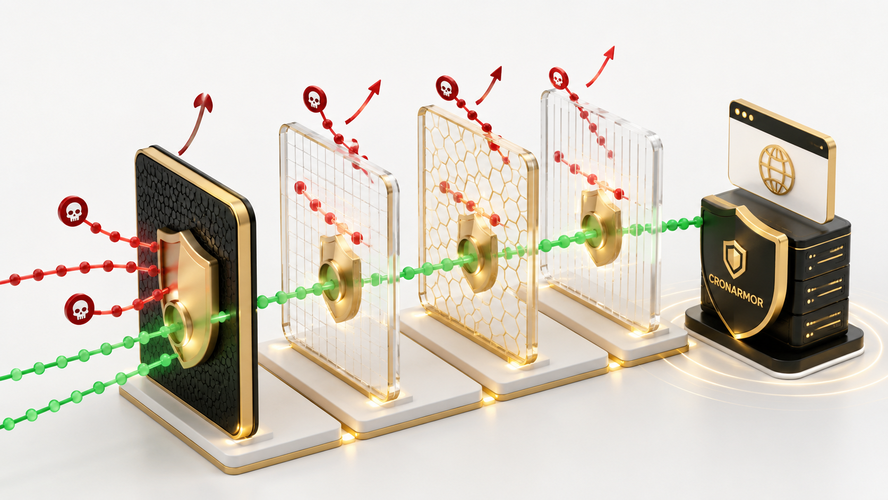
Проверка явно нежелательных запросов
Запросы с признаками заведомо ненужной активности могут быть прекращены ещё до передачи основному сайту.
Разделение доверенного и недоверенного трафика
Для отдельных типов клиентов используются правила доверия, основанные не на одном заявленном признаке, а на нескольких условиях.
Особенно это важно для поисковых роботов и других необходимых сайту автоматизированных систем.
Фильтрация автоматизированной активности
Для неоднозначного трафика применяются дополнительные уровни проверки, позволяющие отличать обычное посещение от автоматизированного сценария.
Поведенческий анализ
Отдельное внимание уделяется активности, которая внешне напоминает работу браузера, но отличается характером поведения.
Это важно для защиты от:
- поведенческих ботов;
- автоматизированной накрутки;
- массового парсинга;
- нежелательных автоматизированных переходов;
- нагрузки на поиск и фильтры;
- автоматизированной работы с динамическими функциями сайта.
Индивидуальные правила
Защита адаптируется под функции конкретного сайта.
Для одного проекта может быть особенно важна форма обратной связи, для другого — каталог, для третьего — авторизация, API, AJAX или личный кабинет.
Поэтому набор правил должен учитывать реальную структуру проекта, а не состоять из универсального файла, скопированного из интернета.
Что происходит с нагрузкой при облачной фильтрации
При локальной блокировке нежелательный клиент непосредственно обращается к серверу сайта.
При облачной схеме значительная часть нежелательных запросов обрабатывается защитным контуром до передачи на основной сервер.
Это особенно важно для проектов, где автоматизированная активность создаёт дополнительную нагрузку на:
- CMS;
- базу данных;
- поиск;
- фильтры;
- каталог;
- API;
- формы;
- динамические обработчики.
Один автоматизированный запрос внешне может быть небольшим, но внутри сайта запускать тяжёлую серверную операцию. Поэтому оценивать влияние ботов только по объёму входящих данных неправильно.
Нужно ли полностью отказываться от .htaccess
Нет. У .htaccess остаются собственные задачи.
Его вполне можно использовать для:
- редиректов;
- локального ограничения служебных каталогов;
- работы с определёнными параметрами сайта;
- небольших статических правил доступа;
- технической конфигурации приложения.
Ошибка заключается не в использовании .htaccess, а в попытке сделать из него полноценную антибот-систему.
Правильный подход: использовать каждый инструмент на своём уровне. Локальная конфигурация решает локальные серверные задачи, а управление и фильтрация входящего веб-трафика выполняются специализированным защитным контуром.
.htaccess или WAF: сравнение подходов
| Возможность | .htaccess | Облачный WAF |
|---|---|---|
| Простой запрет IP | Да | Да |
| Блокировка по User-Agent | Да | Да, как один из признаков |
| Фильтрация до передачи запроса сайту | Нет | Да |
| Многоуровневая классификация трафика | Сильно ограничена | Да |
| Работа с поведенческими признаками | Не является профильной задачей | Да |
| Индивидуальные правила для функций сайта | Возможны, но быстро усложняются | Да |
| Контролируемый пропуск поисковых роботов | Ограниченные возможности | Многоуровневая проверка |
| Централизованное управление защитой | Нет | Да |
| Отделение защиты от CMS сайта | Нет | Да |
| Профессиональное сопровождение правил | Не предусмотрено самим механизмом | Да |
Почему готовые наборы правил из интернета не являются системой защиты
Популярность .htaccess во многом объясняется простотой копирования.
Пользователь находит статью:
«1000 ботов, которых нужно заблокировать на любом сайте»
копирует список и получает ощущение законченной защиты.
Но неизвестно:
- когда составлялся этот список;
- актуальны ли указанные данные;
- почему конкретный клиент попал в блокировку;
- не принадлежит ли адрес легитимному сервису;
- не изменилось ли назначение сети;
- не затрагивает ли правило полезный трафик;
- какие боты просто изменили свои признаки и спокойно проходят дальше.
Без постоянного анализа трафика такой список быстро превращается в исторический набор строк, а не в актуальную систему безопасности.
Защита от ботов должна быть управляемым процессом
Автоматизированный трафик постоянно меняется.
Поэтому эффективная защита — это не однократная установка нескольких правил, а процесс:
- анализ входящего трафика;
- выделение групп автоматизированной активности;
- создание правил фильтрации;
- контроль ложных срабатываний;
- наблюдение за изменениями;
- корректировка защиты.
Именно поэтому для серьёзных проектов важна не только технология WAF, но и сопровождение работающей системы защиты.
Стоит ли защищать сайт от ботов через .htaccess
Использовать .htaccess для нескольких простых статических ограничений допустимо.
Например, если известен конкретный нежелательный адрес или необходимо закрыть служебный каталог, локальное правило может оказаться вполне достаточным.
Но строить полноценную защиту сайта от современного автоматизированного трафика исключительно на .htaccess нецелесообразно.
Причина не в недостатке количества правил. Можно написать сто, тысячу или десять тысяч условий. Проблема заключается в самой архитектуре подхода.
Современная защита должна:
- работать до передачи нежелательного запроса приложению;
- использовать несколько независимых признаков;
- различать доверенных и недоверенных роботов;
- учитывать поведение;
- защищать динамические функции;
- адаптироваться под конкретный сайт;
- позволять контролировать качество фильтрации;
- корректироваться по мере изменения трафика.
.htaccess для этого изначально не создавался.
Профессиональная защита сайта без .htaccess
Для системной защиты от автоматизированного и вредоносного веб-трафика правильнее использовать отдельный облачный защитный контур.
CRONARMOR выполняет фильтрацию HTTP/HTTPS-трафика на уровне облачного WAF-шлюза до передачи разрешённых запросов на основной сервер сайта.
Такой подход позволяет строить не один универсальный запрет, а последовательную многоуровневую систему:
- ранняя фильтрация явно нежелательных запросов;
- проверка технических признаков клиента;
- контролируемый пропуск доверенных поисковых роботов;
- дополнительные проверки неоднозначного автоматизированного трафика;
- поведенческая фильтрация;
- индивидуальные правила для конкретных функций проекта;
- защита форм, поиска, авторизации, API и динамических функций;
- контроль и корректировка правил в процессе эксплуатации.
В результате защита перестаёт быть набором разрозненных запретов внутри сайта и становится отдельным управляемым контуром фильтрации веб-трафика.
Итог: .htaccess полезен как локальный конфигурационный инструмент, но не должен подменять собой полноценную систему защиты от ботов. Для небольшого статического ограничения достаточно правила. Для постоянного контроля автоматизированного трафика нужен специализированный WAF-контур с многоуровневой фильтрацией и сопровождением.
Вывод
Попытка защитить сайт от ботов через .htaccess выглядит привлекательно благодаря кажущейся простоте: файл уже существует, правила можно найти бесплатно, а изменение занимает несколько минут.
Но реальный веб-трафик значительно сложнее списка User-Agent и IP-адресов.
Современные автоматизированные системы умеют имитировать браузеры, менять инфраструктуру, распределять запросы, обращаться непосредственно к динамическим функциям и адаптироваться к простым блокировкам.
Поэтому увеличение количества правил в .htaccess не превращает его в профессиональную антибот-систему. Наоборот, чрезмерное усложнение локальной конфигурации повышает риск ложных блокировок, ошибок, нарушения работы сайта и проблем с сопровождением.
Для качественной защиты задача должна решаться до передачи нежелательного трафика основному сайту, с использованием многоуровневой фильтрации и индивидуальных правил.
Именно такой принцип применяется в облачном WAF-контуре CRONARMOR.
Нужна защита сайта от ботов?
CRONARMOR выполняет фильтрацию автоматизированного и вредоносного веб-трафика до его передачи на основной сервер сайта. Защита настраивается с учётом структуры проекта, его функций и фактического характера входящего трафика.
Ниже можно оставить заявку на подключение защиты. После предварительного осмотра сайта специалист CRONARMOR определит подходящий вариант подключения и необходимые уровни фильтрации.