Парсинг сайта конкурентами. Угрозы и безопасность сайта
Парсинг сайта — это автоматизированный сбор информации со страниц. Сам по себе он не всегда является атакой: поисковые системы индексируют контент, сервисы мониторинга проверяют доступность, агрегаторы собирают открытые данные. Но когда сайт систематически копируют конкуренты или сторонние коммерческие системы, последствия могут выходить далеко за рамки обычной нагрузки на сервер.
Автоматизированный парсер способен обходить тысячи карточек товаров, собирать цены, характеристики, остатки, тексты, изображения, структуру каталога и другие сведения. Для владельца ресурса это может означать потерю конкурентного преимущества, рост технической нагрузки, ухудшение качества аналитики и появление дополнительных рисков безопасности.
Важно отличать сам факт автоматического сбора данных от взлома. Парсер может работать только с общедоступными страницами и не нарушать работу приложения. Но интенсивный или плохо настроенный сбор способен создавать нагрузку, а попытки обходить ограничения и обращаться к техническим endpoint-ам уже требуют более внимательного отношения.
Главный принцип: не весь автоматизированный сбор данных одинаково опасен. Для защиты важно определить, кто обращается к сайту, какие данные собираются, с какой интенсивностью и как это влияет на работу проекта.
Что конкуренты могут собирать с сайта
Объём доступной информации зависит от типа проекта. Интернет-магазины и каталоги наиболее интересны для автоматизированного сбора, потому что содержат хорошо структурированные данные.
- цены и историю их изменения;
- наличие и остатки товаров;
- артикулы, характеристики и модификации;
- структуру категорий и фильтров;
- тексты карточек и описания услуг;
- изображения и медиаматериалы;
- контактные данные;
- условия доставки, акции и специальные предложения;
- состав ассортимента и скорость появления новых позиций.
На корпоративных сайтах интерес могут представлять прайс-листы, техническая документация, публичные базы знаний, список проектов и другие сведения, которые помогают анализировать коммерческую стратегию компании.
Почему парсинг особенно важен для интернет-магазинов
Для электронной коммерции автоматизированный сбор цен стал обычной частью рынка. Конкурент может быстро увидеть изменение стоимости, сравнить ассортимент и скорректировать собственное предложение. Чем чаще обновляются данные, тем выше ценность регулярного парсинга.
С точки зрения безопасности проблема возникает тогда, когда сбор становится чрезмерно интенсивным, мешает реальным посетителям или используется вместе с другими автоматизированными действиями — массовыми запросами к фильтрам, API, поиску или техническим разделам.
Для бизнеса парсинг — это не только вопрос нагрузки. Он может раскрывать динамику цен, ассортиментную стратегию и изменения каталога значительно быстрее, чем это можно было бы отслеживать вручную.
Как парсер выглядит на уровне сервера
На сервере парсер проявляется как последовательность HTTP-запросов к страницам сайта. Простой скрипт может быстро обходить URL один за другим. Более сложная автоматизация имитирует браузер, выполняет JavaScript, получает cookies и выдерживает паузы между запросами.
При анализе важна не одна характеристика, а совокупность признаков. Например, высокая частота запросов сама по себе может быть результатом нормальной работы поискового робота. Поэтому технические данные нужно сопоставлять с типом клиента и характером обхода.
- частое последовательное открытие карточек товаров;
- обход больших диапазонов URL;
- повторяющийся маршрут по каталогу;
- минимальные паузы между запросами;
- отсутствие обычных пользовательских переходов;
- повторяемость запросов с разных IP;
- характерные обращения к фильтрам, поиску и API;
- систематическая загрузка однотипного контента.
Почему одного IP недостаточно
Простой парсер действительно может работать с одного сервера и одного IP. Но современные системы часто распределяют запросы между множеством адресов, используют облачные платформы, прокси и мобильные сети. Поэтому блокировка одного адреса может лишь временно уменьшить поток.
С другой стороны, крупный провайдер или мобильная сеть обслуживают реальных посетителей. Блокировать широкий диапазон только потому, что внутри него обнаружен парсер, опасно: можно одновременно закрыть доступ настоящим клиентам.
User-Agent тоже легко меняется
User-Agent полезен для классификации известных роботов, но произвольный парсер способен заявить строку обычного Chrome, Firefox или мобильного браузера. Поэтому доверять только названию клиента нельзя.
Для известных поисковых систем имеет смысл проверять не только User-Agent, но и принадлежность запроса ожидаемой инфраструктуре. Для неизвестных клиентов важнее анализ поведения и согласованности технических признаков.
Когда парсинг начинает создавать нагрузку
Не каждая страница одинаково дорога для сервера. Статический файл может обслуживаться почти без нагрузки, а сложный фильтр каталога способен запускать тяжёлые запросы к базе данных. Поэтому даже умеренное количество автоматизированных обращений иногда создаёт заметную нагрузку.
Особенно чувствительны динамические страницы, поиск по сайту, фильтры, сортировки, API и генерация персонализированного содержимого. Если парсер систематически обходит такие URL, нагрузка может увеличиваться непропорционально числу запросов.
Как парсинг искажает веб-аналитику
Если парсер использует полноценный браузер и выполняет код счётчика, его сессии могут попадать в Яндекс Метрику и другие аналитические системы. Тогда меняются посещаемость, глубина просмотра, время на сайте, источники трафика и распределение устройств.
Простой HTTP-парсер, наоборот, может вообще не отображаться в Метрике, хотя сервер будет обрабатывать тысячи запросов. Поэтому веб-аналитика не должна быть единственным источником для оценки автоматизированного сбора.
Почему access-логи важнее для технической диагностики
Access-лог фиксирует фактические обращения к сайту независимо от того, выполнился ли JavaScript-счётчик. В нём можно увидеть URL, время запроса, IP, User-Agent, код ответа и другие параметры.
| Источник данных | Что помогает понять |
|---|---|
| Яндекс Метрика | Как автоматизированные браузеры выглядят как пользовательские сессии. |
| Access-лог | Фактический объём HTTP-запросов и структуру обхода. |
| Reverse proxy / WAF | Какие запросы были разрешены, ограничены или заблокированы. |
| Мониторинг сервера | Влияние автоматизации на CPU, память, базу данных и время ответа. |
Парсинг и копирование контента
Отдельная проблема — систематическое копирование текстов, описаний и изображений. Технически защита сайта не может определить юридическую цель каждого посетителя, но может выявлять массовый автоматизированный сбор и снижать его интенсивность.
При этом важно не мешать поисковым системам индексировать публичный контент. Поэтому задача не сводится к запрету любого робота: нужно отделять доверенную индексацию от нежелательной автоматизации.
Почему robots.txt не является защитой от парсеров
robots.txt — это набор рекомендаций для добросовестных роботов. Поисковые системы обычно учитывают эти правила, но произвольный скрипт не обязан им следовать. Поэтому файл robots.txt полезен для управления индексированием, но не является механизмом контроля доступа.
robots.txt не является файрволом. Он сообщает правила добросовестным роботам, но технически не запрещает клиенту открыть публичный URL.
Можно ли полностью запретить парсинг
Если информация открыта в браузере для любого посетителя, полностью исключить возможность её автоматизированного чтения практически невозможно. Любой контент, который должен увидеть человек, технически может быть получен программой.
Реалистичная цель защиты — не обещать абсолютную невозможность копирования, а сделать массовый автоматизированный сбор дороже, медленнее и менее стабильным, одновременно сохраняя нормальную работу сайта для людей и доверенных сервисов.
Почему простые ограничения по частоте помогают не всегда
Rate limit хорошо работает против агрессивного клиента, который создаёт много запросов с одного адреса. Но распределённый парсер может снизить скорость каждого отдельного источника и распределить обход по множеству IP.
Поэтому лимиты полезны как один слой защиты, но для сложного трафика нужны дополнительные признаки: сетевые характеристики, повторяемость маршрутов, browser fingerprint, cookies и результаты проверок.
Проверки JavaScript и cookies
Браузерная проверка отсеивает часть простых HTTP-клиентов. Если посетителю нужно выполнить JavaScript и вернуть корректный cookie, обычный скрипт без браузера может остановиться.
Но полноценные headless-браузеры умеют проходить такие проверки. Поэтому JavaScript-челлендж не должен рассматриваться как абсолютное доказательство присутствия человека.
Когда CAPTCHA уместна, а когда мешает
CAPTCHA может быть полезна как дополнительный шаг для действительно спорного трафика, но постоянная проверка всех посетителей ухудшает пользовательский опыт и способна снижать конверсию.
Лучше использовать многоуровневую схему: доверенный трафик пропускать незаметно, явно нежелательный останавливать сразу, а дополнительную проверку показывать только промежуточной группе.
Как отличить парсер от реального покупателя
Один реальный посетитель тоже может быстро открыть десятки карточек или пользоваться фильтрами. Поэтому отдельная сессия редко даёт уверенный ответ. Более показателен устойчивый профиль большого числа запросов.
- повторяемая последовательность карточек;
- неестественно равномерная скорость обхода;
- минимальная вариативность поведения;
- постоянный обход всего каталога;
- отсутствие обычных действий покупателя;
- массовое повторение одного сценария с разных сетей.
Как не заблокировать поисковые системы
Google, Яндекс и другие поисковые системы тоже автоматически обходят страницы. Для SEO критично не перепутать их с нежелательным парсером. Известных роботов желательно проверять по совокупности User-Agent и сетевой принадлежности, а не доверять только строке браузера.
Как CRONARMOR фильтрует нежелательный парсинг
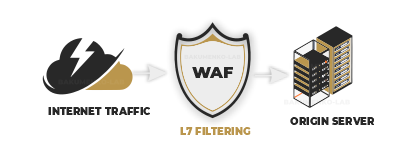
CRONARMOR работает на внешнем защитном контуре перед основным сервером. Это позволяет анализировать запрос до передачи его CMS или приложению и принимать решение по нескольким категориям признаков.
- IP, ASN и сетевой профиль;
- HTTP-характеристики;
- частота и структура обращений;
- последовательность URL;
- браузерные признаки;
- cookies и результаты дополнительных проверок;
- индивидуальные особенности конкретного сайта;
- доверенный пропуск поисковых роботов и необходимых сервисов.
Задача защиты — не запретить всё автоматическое. Нужно уменьшить нежелательный коммерческий и технический сбор данных, сохраняя доступ для реальных пользователей, поисковых систем и полезных интеграций.
Что может сделать владелец сайта
- Проверить access-логи и определить масштаб автоматизированного обхода.
- Выделить самые дорогие для сервера URL: поиск, фильтры, API и динамические страницы.
- Настроить разумные ограничения частоты.
- Закрыть непубличные технические endpoint-ы.
- Разделить доверенных роботов и неизвестную автоматизацию.
- Использовать reverse proxy или WAF для фильтрации до CMS.
- Контролировать ложные блокировки и влияние защиты на SEO.
FAQ
Парсинг сайта — это всегда атака?
Нет. Автоматический сбор используется поисковиками, мониторингом и другими легитимными сервисами. Проблема определяется целью, интенсивностью и влиянием на сайт.
Можно ли запретить конкуренту копировать открытые цены?
Технически полностью исключить чтение общедоступной информации невозможно. Защита может усложнить и ограничить массовый автоматизированный сбор.
Поможет ли robots.txt?
Только для добросовестных роботов. Произвольный парсер может игнорировать этот файл.
Почему парсер не всегда виден в Метрике?
Простой HTTP-клиент может не выполнять JavaScript и не запускать код счётчика. Его активность при этом будет видна в серверных логах.
Можно ли блокировать парсер только по IP?
Для простого источника это иногда помогает, но распределённая автоматизация меняет адреса. Кроме того, широкая IP-блокировка может затронуть реальных пользователей.
Нужно защитить сайт от нежелательного парсинга?
CRONARMOR анализирует сетевые, HTTP- и браузерные признаки трафика и помогает ограничивать автоматизированный сбор данных до передачи запросов на основной сервер сайта.