Как снизить нагрузку от ботов без блокировки поисковых систем
Боты могут создавать заметную нагрузку на сайт даже тогда, когда не пытаются его взломать. Парсеры, сканеры, мониторинги, агрегаторы, AI-краулеры и другие автоматизированные клиенты способны обращаться к тысячам страниц, запускать тяжёлые фильтры, перегружать поиск и увеличивать количество запросов к PHP и базе данных.
Проблема в том, что вместе с нежелательной автоматизацией сайт посещают и полезные роботы — прежде всего поисковые системы. Если применить грубую блокировку по User-Agent, ASN или частоте запросов, можно случайно ограничить Googlebot, Яндекс.Бота и другие сервисы, от которых зависит индексация и видимость сайта в поиске.
Поэтому задача состоит не в том, чтобы «запретить всех ботов», а в том, чтобы разделить автоматизированный трафик на полезный и нежелательный. Это требует нескольких уровней контроля: проверки известных поисковых роботов, ограничения агрессивных сценариев, кеширования, защиты тяжёлых endpoint-ов и фильтрации запросов до основного приложения.
Главный принцип: поисковый робот и нежелательный парсер — это оба автоматизированных клиента, но их нельзя обрабатывать одинаково. Защита должна учитывать доверие к источнику и фактическое поведение.
Почему боты создают нагрузку на сайт
Каждый HTTP-запрос требует ресурсов. Простая статическая картинка может отдаваться почти без затрат, а динамическая страница каталога способна запускать PHP, обращаться к базе данных, выполнять фильтрацию, собирать шаблон и обращаться к внешним сервисам.
- массовый обход страниц;
- частые запросы к поиску;
- перебор фильтров каталога;
- обращения к API;
- загрузка динамических страниц без кеша;
- сканирование служебных URL;
- повторные запросы к одним и тем же ресурсам.
Поэтому одинаковое число запросов может создавать совершенно разную нагрузку в зависимости от того, какие URL вызываются.
Почему нельзя просто блокировать всех роботов
Поисковые системы должны регулярно переобходить сайт, чтобы видеть новые страницы, изменения контента и обновления каталога. Если случайно заблокировать их, страницы могут медленнее обновляться в индексе или вообще перестать нормально сканироваться.
Задача защиты — не минимальное число запросов, а правильный состав трафика. Полезные роботы должны получать доступ, а нежелательная автоматизация — ограничиваться.
Не доверяйте поисковому роботу только по User-Agent
Любой клиент может отправить строку User-Agent, похожую на Googlebot или YandexBot. Поэтому простое правило «если в User-Agent есть Googlebot — разрешить» недостаточно. Нежелательный сканер способен использовать ту же строку.
Для доверенных поисковых роботов желательно проверять дополнительные признаки: сетевую принадлежность, ASN и официально используемую инфраструктуру. Только сочетание User-Agent и ожидаемой сети даёт более надёжное основание для доверия.
Разделите известных и неизвестных ботов
Условно автоматизированный трафик можно разделить на несколько групп.
| Группа | Как обрабатывать |
|---|---|
| Проверенные поисковые роботы | Разрешать при подтверждённой сетевой принадлежности. |
| Известные полезные сервисы | Разрешать по отдельным доверенным правилам. |
| Неизвестная автоматизация | Анализировать частоту, сеть, поведение и браузерные признаки. |
| Явно вредоносные сканеры | Блокировать до передачи приложению. |
Ограничивайте тяжёлые URL, а не весь сайт
Если нагрузку создают поиск, фильтры, API или отдельные страницы, нет смысла вводить одинаковый лимит для всего сайта. Лучше применять более строгие ограничения только к дорогим endpoint-ам.
- поиск по сайту;
- фасетные фильтры;
- сложные сортировки;
- AJAX-запросы;
- API;
- административные и служебные маршруты.
Такой подход уменьшает риск случайно ограничить нормальный обход страниц поисковыми системами.
Используйте кеширование
Если публичная страница может быть закеширована, повторный запрос к ней обходится серверу значительно дешевле. Это полезно и для людей, и для роботов.
Кеширование не заменяет фильтрацию, но снижает последствия массового обхода. При этом динамические области, корзина, личный кабинет и персонализированные страницы нужно исключать из общего кеша корректно.
Rate limit нужно настраивать аккуратно
Ограничение частоты запросов — один из самых очевидных способов снизить нагрузку. Но слишком жёсткий лимит способен затронуть реальных посетителей, корпоративные сети и поисковых роботов.
Лучше использовать разные лимиты для разных категорий: доверенным роботам разрешать больше, неизвестной автоматизации — меньше, а особенно дорогим endpoint-ам назначать собственные ограничения.
Почему лимит только по IP работает не всегда
Современные парсеры и сканеры могут распределять запросы между множеством IP. При этом каждый отдельный адрес остаётся ниже лимита. С другой стороны, за одним IP мобильного оператора или корпоративного прокси может находиться множество реальных пользователей.
Поэтому IP полезен как один из признаков, но для сложной фильтрации нужно учитывать ASN, cookies, browser fingerprint и повторяемость поведения.
Фильтрация до PHP снижает нагрузку сильнее
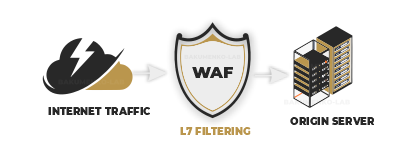
Если нежелательный запрос блокируется только внутри CMS, сервер уже потратил ресурсы на запуск PHP, загрузку ядра и иногда запросы к базе данных. Гораздо эффективнее остановить очевидный бот-трафик на reverse proxy или WAF до приложения.
Это особенно заметно при атаках на административные URL, формы, поиск и API. Чем раньше запрос прекращён, тем меньше вычислительных ресурсов он потребляет.
Статические файлы лучше обслуживать отдельно
CSS, JavaScript, изображения и шрифты не должны без необходимости проходить через тяжёлую серверную логику. Их можно кешировать и отдавать напрямую веб-сервером или CDN.
Оптимизация и защита дополняют друг друга. Хороший кеш и правильная раздача статики уменьшают стоимость каждого запроса, а WAF снижает количество ненужных запросов.
Как отличить поискового робота от маскирующегося бота
Если неизвестный клиент заявляет User-Agent поисковой системы, но приходит из неподходящей сети или ведёт себя нехарактерно, доверять только строке браузера нельзя. Надёжнее сопоставлять несколько признаков.
- User-Agent;
- ASN и сеть источника;
- характер запрашиваемых URL;
- частоту и последовательность запросов;
- соответствие известному профилю поискового робота.
Не блокируйте поисковую индексацию случайными правилами
Опасны слишком широкие правила вроде блокировки всех дата-центров, всех клиентов без cookies или всех запросов без JavaScript. Поисковые роботы могут не вести себя как обычный пользовательский браузер, поэтому browser challenge нельзя применять к ним без исключений.
Что можно разрешать поисковым системам
После проверки сетевой принадлежности поисковому роботу можно дать отдельный доверенный маршрут через WAF. Это позволяет не показывать ему CAPTCHA, не заставлять выполнять JavaScript и не применять к нему поведенческие проверки, рассчитанные на людей.
Следите не только за количеством запросов, но и за их стоимостью
Сто запросов к закешированной странице могут быть дешевле десяти обращений к тяжёлому фильтру каталога. Поэтому мониторинг нагрузки должен учитывать CPU, время ответа, запросы к базе и конкретные URL.
| Тип запроса | Обычно создаёт нагрузку |
|---|---|
| Закешированная статическая страница | Низкую. |
| Поиск | Среднюю или высокую. |
| Сложный фильтр каталога | Высокую. |
| API-запрос с вычислениями | Зависит от реализации. |
| Административный endpoint | Может быть высокой и требует отдельной защиты. |
Как CRONARMOR снижает нагрузку от ботов
CRONARMOR работает перед основным сервером сайта. Это позволяет отделять доверенные поисковые системы от неизвестной автоматизации и блокировать часть нежелательных запросов до запуска CMS.
- доверенный пропуск проверенных поисковых роботов;
- анализ ASN и сетевых характеристик;
- фильтрация известных сканеров;
- ограничение агрессивных парсеров;
- отдельные правила для тяжёлых endpoint-ов;
- браузерные проверки для подозрительного трафика;
- индивидуальные исключения для AJAX, API и интеграций;
- логирование срабатываний и контроль ложных блокировок.
Правильная фильтрация не должна мешать SEO. Полезные поисковые роботы получают доверенный доступ, а ограничения применяются к тем классам автоматизации, которые создают ненужную нагрузку или ведут себя подозрительно.
Практический чек-лист
- Определить, какие URL создают основную нагрузку.
- Проверить, кто обращается к этим URL.
- Отделить известных поисковых роботов.
- Проверять их не только по User-Agent, но и по сети.
- Включить кеширование публичных страниц.
- Ограничить тяжёлые endpoint-ы отдельными правилами.
- Не применять browser challenge к проверенным поисковым роботам.
- Фильтровать нежелательный трафик до CMS.
- Контролировать логи и ложные срабатывания.
FAQ
Можно ли просто заблокировать всех ботов?
Нет. Вместе с нежелательной автоматизацией вы заблокируете поисковые системы и полезные сервисы.
Как проверить настоящего поискового робота?
Нужно сопоставлять заявленный User-Agent с ожидаемой сетевой инфраструктурой и другими техническими признаками.
Поможет ли только rate limit?
Против простого агрессивного клиента — да. Распределённые парсеры могут обходить лимиты, поэтому нужны дополнительные признаки.
Стоит ли показывать CAPTCHA поисковым роботам?
Нет. Проверенным поисковым роботам лучше давать доверенный доступ без пользовательских challenge-механизмов.
Что сильнее всего снижает нагрузку?
Комбинация кеширования, ранней фильтрации нежелательных запросов и отдельных ограничений для самых дорогих endpoint-ов.
Нужно снизить нагрузку от ботов без потери поискового трафика?
CRONARMOR отделяет доверенных поисковых роботов от нежелательной автоматизации и фильтрует лишние запросы до передачи на основной сервер сайта.