Как сканеры ищут уязвимости на сайте
Сканеры уязвимостей — это автоматизированные системы, которые обходят сайты и пытаются определить, какие технологии используются, какие служебные адреса доступны извне и есть ли признаки типовых ошибок конфигурации. Одни сканеры применяются администраторами и специалистами по безопасности, другие постоянно перебирают сайты в интернете в поиске слабых мест.
Внешне такое сканирование может выглядеть по-разному. Иногда это десятки запросов к известным служебным URL за несколько секунд. В других случаях сканер работает медленно, меняет IP-адреса и распределяет проверку во времени. Поэтому владелец сайта может долго не замечать автоматизированное исследование, особенно если смотрит только на обычную веб-аналитику.
Сам факт сканирования ещё не означает успешный взлом. Сначала система собирает сведения и ищет признаки потенциальных слабых мест. Реальная опасность возникает тогда, когда найденная ошибка действительно существует и может быть использована дальше.
Важно: сканер уязвимостей не обязательно «ломает» сайт. На первом этапе он чаще занимается разведкой: определяет технологии, доступные точки входа и характер ответов сервера.
Что именно пытается узнать сканер
Перед проверкой конкретных слабых мест автоматизированная система старается составить технический профиль сайта. Чем больше информации удаётся получить, тем точнее выбираются дальнейшие проверки.
- какой веб-сервер используется;
- какая CMS или веб-платформа установлена;
- есть ли административные и служебные разделы;
- какие плагины, модули и компоненты доступны извне;
- как сервер отвечает на несуществующие и запрещённые URL;
- какие HTTP-заголовки и cookies выставляет приложение;
- есть ли признаки устаревшего или неправильно настроенного ПО;
- какие технические endpoint-ы доступны без авторизации.
Первый этап: определение технологий
Сканер анализирует ответы сервера, структуру HTML, характерные пути, названия файлов, cookies, заголовки и другие признаки. По ним можно предположить использование WordPress, 1С-Битрикс, Joomla, Drupal, самописного фреймворка или другой платформы.
Точный номер версии определить удаётся не всегда. Современные сайты скрывают часть технической информации, используют reverse proxy и CDN. Поэтому хороший сканер не полагается на один заголовок, а собирает несколько косвенных признаков.
Главная цель первого этапа — сузить область поиска. Если сканер понимает, что перед ним определённая CMS, ему уже не нужно проверять весь набор известных технологий.
Проверка типовых служебных адресов
Один из самых заметных видов сканирования — обращения к известным административным и служебным путям. Такие запросы могут идти к страницам входа, API, диагностическим файлам, резервным копиям, тестовым каталогам и другим адресам, часто встречающимся у популярных платформ.
Для владельца сайта это может выглядеть как последовательность запросов к URL, которые вообще не используются проектом. Если сайт не работает на WordPress, а в логах регулярно появляются попытки открыть характерные WordPress-пути, почти наверняка перед нами автоматический массовый сканер.
Почему сканеры перебирают даже несуществующие URL
Массовый сканер заранее не знает, какая CMS установлена на конкретном домене. Поэтому он пробует набор типовых адресов и смотрит на ответы сервера. Коды 200, 301, 302, 401, 403 и 404 дают разную информацию. Даже отказ в доступе иногда подтверждает, что объект существует.
Поиск открытых резервных копий и технических файлов
Ошибочно опубликованные архивы, дампы, временные файлы и копии конфигураций особенно интересны для автоматизированных проверок. Они могут появляться после ручного обслуживания, миграции, обновления или аварийного восстановления.
Правильная практика — не хранить резервные копии и конфигурационные файлы в публичной части сайта. Если технический файл нужен администратору, он должен находиться вне web-root или быть недоступен извне.
Сканирование форм и точек ввода
Формы поиска, обратной связи, авторизации, фильтры каталога, параметры URL и API становятся отдельным объектом анализа. Сканер проверяет, как приложение обрабатывает необычные или некорректные значения и не раскрывает ли лишнюю техническую информацию в ответах.
Защищённое приложение должно корректно обрабатывать неожиданные данные, не выдавать внутренние ошибки пользователю и не раскрывать структуру базы данных, файловой системы или используемого кода.
Почему сканер часто заметен в access-логах
Даже если сканер не отображается в Яндекс Метрике, его запросы видны серверу. Access-лог фиксирует обращения к URL, коды ответов, IP-адрес, User-Agent и время запросов. Именно поэтому серверные журналы остаются одним из основных источников при поиске сканирования.
- много запросов к служебным URL;
- обращения к технологиям, которых нет на сайте;
- высокая доля ответов 404 и 403;
- частые запросы с одного IP или группы сетей;
- последовательный перебор похожих путей;
- нехарактерные HTTP-методы;
- повторяемые шаблоны запросов на разных сайтах.
Почему часть сканеров не видна в Метрике
Яндекс Метрика работает на стороне браузера и учитывает визиты, в которых выполнился код счётчика. Многие технические сканеры не загружают страницу как полноценный браузер и не исполняют JavaScript. Поэтому они могут создавать заметную нагрузку на сервер и почти не отображаться в обычных отчётах аналитики.
Отсутствие аномалий в Метрике не означает отсутствие автоматизированных запросов. Для технического анализа необходимы server access logs, reverse proxy или WAF.
Медленное сканирование сложнее заметить
Не каждый сканер отправляет сотни запросов в секунду. Чтобы не попасть под простые лимиты, запросы могут распределяться по времени и между разными IP. В этом случае каждый отдельный адрес создаёт небольшую нагрузку, но суммарно инфраструктура продолжает исследовать сайт.
Поэтому правила, основанные только на количестве запросов с одного IP, защищают лишь от части автоматизации. Для более точного выявления нужно анализировать структуру запросов, повторяемость путей и сетевые характеристики.
Сканирование через обычный браузер
Некоторые системы используют браузерную автоматизацию. Тогда запросы становятся похожими на действия пользователя: выполняется JavaScript, создаются cookies, загружаются стили и изображения. Такие проверки труднее отделить от обычного трафика, но при массовой работе часто сохраняются повторяющиеся маршруты и технические признаки окружения.
Вывод: отсутствие высокой частоты запросов не означает отсутствие сканирования. Современная автоматизация может работать медленно и распределённо.
Чем сканер уязвимостей отличается от поискового робота
| Тип автоматизации | Типичное поведение |
|---|---|
| Поисковый робот | Обходит страницы для индексирования, следует ссылкам, обычно идентифицирует себя и работает из известной инфраструктуры. |
| Мониторинг | Регулярно проверяет ограниченный набор URL и ожидаемые коды ответа. |
| Парсер | Собирает содержимое страниц, цены, карточки товаров или другие данные. |
| Сканер уязвимостей | Проверяет служебные пути, необычные URL, ошибки конфигурации и потенциально опасные точки входа. |
На практике границы между классами могут пересекаться. Поэтому решение о блокировке лучше принимать не по названию User-Agent, а по фактическому поведению и доверию к источнику.
Почему нельзя блокировать всех роботов одинаково
Среди автоматизированного трафика есть поисковые системы, сервисы мониторинга, платёжные системы, мессенджеры, средства проверки ссылок и другие полезные клиенты. Грубое правило «всё автоматическое запрещать» способно нарушить индексацию и работу сайта.
Хорошая защита разделяет доверенные сервисы, нейтральную автоматизацию и нежелательные сканеры. Для известных роботов желательно подтверждать не только User-Agent, но и сетевую принадлежность.
Что делает WAF при сканировании
Web Application Firewall анализирует HTTP-запросы до передачи их приложению. Он может обнаруживать известные сигнатуры, подозрительные комбинации параметров, обращения к запрещённым путям и другие признаки.
При этом WAF не должен превращаться в набор чрезмерно широких запретов. Чем больше сайт использует API, AJAX, формы и внешние интеграции, тем важнее точная настройка исключений и контроль ложных срабатываний.
Почему reverse proxy удобен для фильтрации
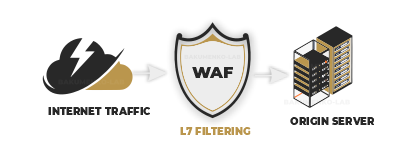
Если защитный reverse proxy находится перед основным сервером, подозрительный запрос можно остановить до того, как он дойдёт до CMS или приложения. Это снижает нагрузку и позволяет централизованно применять правила фильтрации.
Какие признаки особенно характерны для массового сканирования
- частые обращения к несуществующим служебным путям;
- перебор URL разных CMS на одном сайте;
- высокая доля 404, 403 и других ошибок;
- повторяющиеся запросы с одинаковой структурой;
- массовое обращение к файлам конфигурации и резервным копиям;
- проверка административных и API-endpoint-ов;
- одинаковый шаблон запросов на нескольких доменах.
Что не стоит считать доказательством атаки
Один запрос к странному URL ещё ничего не доказывает. Пользователь мог открыть ошибочную ссылку, поисковый робот — проверить старый адрес, а внешний сервис — обратиться к известному endpoint. Важны повторяемость и контекст.
- одиночный ответ 404;
- один необычный User-Agent;
- один запрос к странице входа;
- одно обращение из дата-центра;
- кратковременный всплеск без повторения.
Как CRONARMOR работает со сканерами
CRONARMOR фильтрует трафик перед основным сервером сайта и использует несколько уровней анализа. Задача — не просто заблокировать максимальное количество запросов, а отделить нежелательное сканирование от полезных роботов и реальных пользователей.
- анализ сетей и ASN;
- проверка HTTP-характеристик;
- сигнатуры известных нежелательных запросов;
- индивидуальные правила для конкретного сайта;
- доверенный пропуск поисковых роботов и внешних сервисов;
- дополнительные браузерные проверки для спорных запросов;
- анализ повторяемости и поведения.
Эффективная защита от сканеров — это не один запрет, а система. Она должна учитывать сеть, HTTP-запрос, поведение, доверенные сервисы и особенности самого сайта.
Что должен сделать владелец сайта
- Регулярно обновлять CMS, плагины и модули.
- Не хранить резервные копии в публичных каталогах.
- Ограничивать доступ к служебным и административным разделам.
- Не раскрывать лишнюю техническую информацию в ошибках.
- Проверять access-логи на массовые обращения к служебным URL.
- Использовать WAF или reverse proxy для внешней фильтрации.
- Следить за ложными срабатываниями и доступностью сайта для поисковых роботов.
FAQ
Сканирование сайта означает, что его уже взломали?
Нет. Сканирование — это поиск информации и потенциальных слабых мест. Успешная эксплуатация уязвимости — отдельный этап.
Можно ли полностью запретить сканирование?
Полностью исключить попытки извне невозможно, если сайт доступен из интернета. Но можно существенно уменьшить объём нежелательных запросов и не давать им доходить до приложения.
Почему сканеры не всегда видны в Метрике?
Многие из них не выполняют JavaScript и не запускают код счётчика аналитики. Их деятельность лучше видна в серверных логах.
Нужно ли блокировать все запросы к служебным страницам?
Нет универсального ответа. Если путь точно не используется сайтом, его можно ограничить. Если это рабочая административная или API-точка, нужно учитывать легитимных пользователей и интеграции.
Нужно защитить сайт от автоматизированного сканирования?
CRONARMOR фильтрует нежелательные запросы на внешнем защитном контуре, анализируя сетевые и HTTP-признаки, сигнатуры, поведение и особенности конкретного сайта.